Secondo quanto riportato il 15 ottobre dal Nieman Journalism Lab, e su Linkedin da Guido Scorza, avvocato specializzato in diritto delle nuove tecnologie, già componente del Collegio del Garante per la protezione dei dati personali, Meta aveva aggiornato le proprie condizioni contrattuali, prevedendo la possibilità di raccogliere contenuti dai siti web degli editori collegati ad account aziendali su Facebook, Instagram e WhatsApp. Le nuove condizioni riguardavano, in generale, gli account aziendali utilizzati per gestire pagine e gruppi, pubblicare inserzioni pubblicitarie, inviare comunicazioni di marketing e utilizzare strumenti come Meta Business Suite. Così come sono formulati, secondo tre esperti legali che hanno esaminato i termini su richiesta di Nieman Lab, i nuovi termini consentirebbero a Meta di estrarre contenuti da siti di notizie e utilizzarli per addestrare i prodotti di intelligenza artificiale dell’azienda.
La notizia ha suscitato forti proteste da parte di organizzazioni internazionali di editori come , News/Media Alliance, WAN-IFRA (associazione mondiale degli editori di notizie), quattro associazioni di stampa europee (l’European Magazine Media Association, l’European Newspaper Publishers’ Association, l’European Press Council e News Media Europe) e tante altre tutte preoccupate che Meta potesse sfruttare i loro contenuti senza un consenso specifico, persino per sviluppare sistemi destinati poi a far concorrenza ai propri prodotti.
Di fronte alle polemiche, secondo quanto riportato da Nieman Journalism, Meta ha modificato le condizioni eliminando il riferimento esplicito all’addestramento (train) e ha circoscritto gli utilizzi dichiarati ai propri prodotti pubblicitari e commerciali, anziché a tutti i prodotti della società.
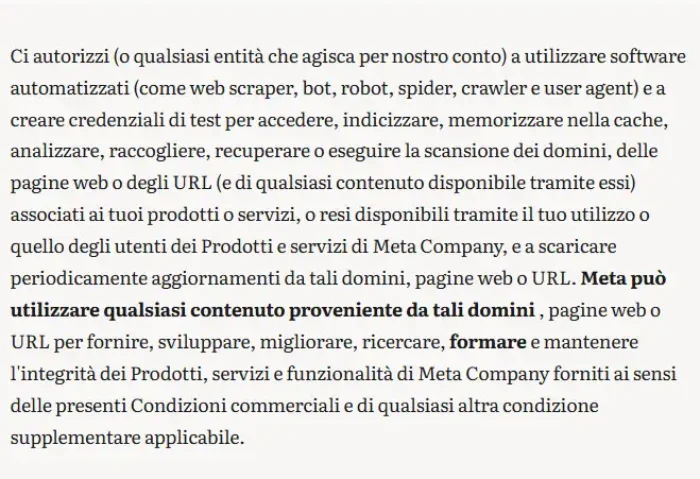
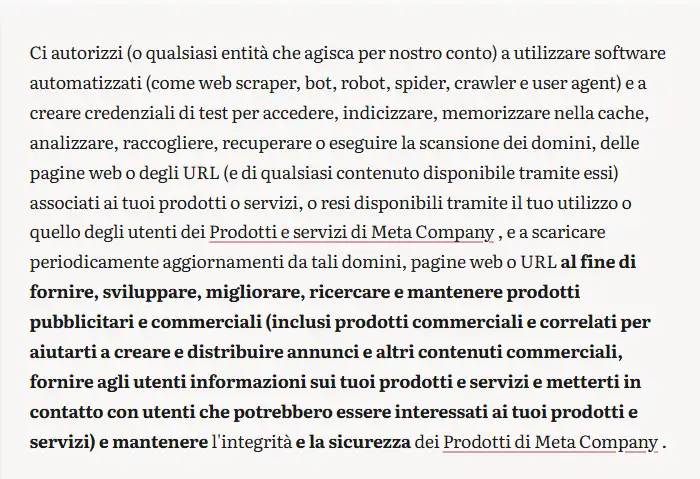
In concreto, ciò significa che i contenuti raccolti potrebbero essere utilizzati, per esempio, per migliorare strumenti come Meta Ads Manager, che consente agli inserzionisti di creare e gestire campagne pubblicitarie, oppure Meta Business Suite, che permette alle aziende e alle testate giornalistiche di gestire pagine Facebook, account Threads, profili Instagram e canali WhatsApp da un’unica piattaforma. La modifica restringe quindi le finalità dichiarate da Meta, ma non elimina la possibilità di raccogliere automaticamente contenuti dai siti web. Inoltre, poiché la clausola continua a utilizzare termini ampi come sviluppare e migliorare, alcuni esperti ritengono che rimangano dubbi sull’eventuale impiego dei contenuti nello sviluppo di prodotti commerciali basati sull’intelligenza artificiale.
Praticamente la questione non viene arginata in nessuno modo se si pensa che quasi ogni testata giornalistica possiede almeno un account aziendale Meta Business Suite.
Inoltre, l’azienda ha aggiunto che gli editori continueranno, comunque, a disporre del diritto di sottrarre qualsiasi contenuto al proprio scraping, semplicemente utilizzando l’apposito comando – il famoso robots.txt – da sempre a loro disposizione. Si tratta di un piccolo file di testo configurato dallo specifico giornale che un sito web può utilizzare per impedire ai sistemi automatici, in questo caso ai bot di Meta, di entrare nelle pagine di un giornale e copiarne gli articoli, le immagini o altri contenuti. Tuttavia, secondo gli esperti legali, i termini rivisti consentiranno comunque lo scraping su larga scala dei siti web, potenzialmente aggirando i file robots.txt.
Meta infine ha rinviato l’entrata in vigore delle nuove condizioni dal 30 ottobre al 20 novembre 2026, per avere più tempo per spiegare le modifiche. Il rinvio, però, non equivale al ritiro della clausola.
La riflessione di Scorza è particolarmente importante in quanto evidenzia un altro problema fondamentale: la tutela dei dati personali delle persone citate negli articoli.
Scorza critica il possibile utilizzo dei contenuti dei giornali da parte di Meta per addestrare i propri algoritmi di intelligenza artificiale, poiché gli editori, pur potendo disporre dei diritti sui propri contenuti, non sono automaticamente autorizzati a concedere a terzi i dati personali che essi contengono. Quando una piattaforma raccoglie migliaia di articoli, non acquisisce soltanto testi protetti dal diritto d’autore, ma raccoglie anche nomi, volti, vicende familiari, informazioni sulla salute, orientamenti politici attribuiti, procedimenti giudiziari e altri dettagli riferiti a persone reali. In sostanza tutta una serie dati personali e/o “sensibili” e normati dagli artt 9 e 10 del GDPR (Regolamento UE 2016/679).
Questi dati personali possono essere presenti nei contenuti degli editori e venire pubblicati per finalità giornalistiche sulla base della disciplina prevista dagli articoli 136 e 137 del Codice della privacy, in coordinamento con l’articolo 85 del GDPR. Tale disciplina consente, a determinate condizioni, il trattamento di dati personali anche senza il consenso dell’interessato, nel rispetto delle regole deontologiche e dei limiti del diritto di cronaca, tra cui il principio dell’essenzialità dell’informazione rispetto a fatti di interesse pubblico.
Pubblicare informazioni per informare i cittadini non è la stessa cosa che autorizzarne l’utilizzo per addestrare sistemi di intelligenza artificiale che raccoglierebbero massivamente e senza alcuna autorizzazione tali dati, creando dei veri e propri trattamenti che ben sappiamo, essere in Europa disciplinati dal già citato Regolamento europeo.